소개
Qube는 dagaza가 개발한 완전 로컬, 프라이버시 우선의 음성 대 음성 AI 데스크톱 어시스턴트입니다. 음성 인식, 텍스트 음성 변환, RAG(검색 증강 생성), 로컬 LLM 추론을 네이티브 PyQt6 데스크톱 셸에 통합합니다. 이 패키지는 CPU 추론 빌드로, 모든 PC에서 작동합니다.
상세정보
Library
PDF, EPUB, 텍스트 문서를 수집하고, 제목과 본문을 검색하며, 벡터 인덱스에서 미리 볼 수 있습니다. 문서와 채팅하려면 @file을 사용합니다.
Memory Manager
채팅에서 추출된 장기 기억(선호도, 프로젝트, 지식)을 계층 필터로 관리하고, 편집, 플래그, 삭제, 내보내기가 가능합니다. 삭제된 기억이 다시 나타나지 않도록 네거티브 리스트도 지원합니다.
Live Sources
일반 웹 검색을 넘어 신뢰할 수 있는 출처(과학 문헌, SEC EDGAR, 미국 판례 등)에 접근할 수 있는 58개 이상의 어댑터를 제공합니다. 비동기 @research 보고서를 생성하고, REST, GraphQL, MCP 등을 통해 사용자 정의 소스를 추가할 수 있습니다.
Model Manager
Hugging Face에서 모델을 검색하고, 큐레이션된 목록을 탐색하며, 모델 README를 앱에서 읽고, .gguf 양자화 파일을 디스크 공간 확인과 함께 다운로드할 수 있습니다. 외부 서버(LM Studio, Ollama)를 지정할 수도 있습니다.
투명성 기능
로컬 텔레메트리, 답변별 INSPECT RETRIEVAL, 진단 로그(선택적, 기기 내 저장)를 제공합니다. 웹 검색은 기본적으로 비공개 검색(DuckDuckGo, Wikipedia)을 사용하며, 자체 SearXNG를 지정할 수 있습니다.
음성 및 접근성 (선택 사항)
푸시투토크, 웨이크 워드, 스트리밍 TTS, barge-in(말하는 중에 중단)을 지원하며, 음성 모델이 설치된 경우에 사용할 수 있습니다. Desktop Companion 오브를 통해 핸즈프리로 사용할 수 있습니다.
Windows (CPU 빌드)
winget을 사용하여 설치합니다:
winget install -e --id dagaza.QubeGPU 가속이 필요한 경우 Vulkan(AMD/Intel) 또는 CUDA(NVIDIA) 빌드를 선택할 수 있습니다.
첫 실행
첫 실행 시 권장 프리셋이 표시됩니다: 필수 사이드카 및 검색 임베딩, 선택적 음성 모델(Whisper, Kokoro TTS), 기본 채팅 모델(약 16GB RAM에 맞게 조정). RAM이 부족하면 음성 모델을 해제하고, LM Studio나 Ollama를 사용하려면 메인 LLM을 해제할 수 있습니다.
외부 백엔드를 사용하려면 Settings → AI & Models에서 LM Studio 또는 Ollama를 지정합니다.
대화를 시작하려면 질문을 입력하고, @library 또는 @evidence를 붙여 근거를 제공하거나, ?를 눌러 가이드 투어를 시작합니다.
Qube는 어떤 모델을 지원하나요?
Model Manager에서 GGUF 형식의 모델(예: NVIDIA-Nem…4_K_M.gguf, Gemma 4 26B A4B)을 선택하고 다운로드할 수 있습니다.
음성 기능은 어떻게 사용하나요?
Settings → Voice & Audio에서 음성 입력과 TTS를 활성화하고, 음성 모델을 설치하면 푸시투토크나 웨이크 워드로 사용할 수 있습니다.
화면으로 보는 주요 기능
대화 화면
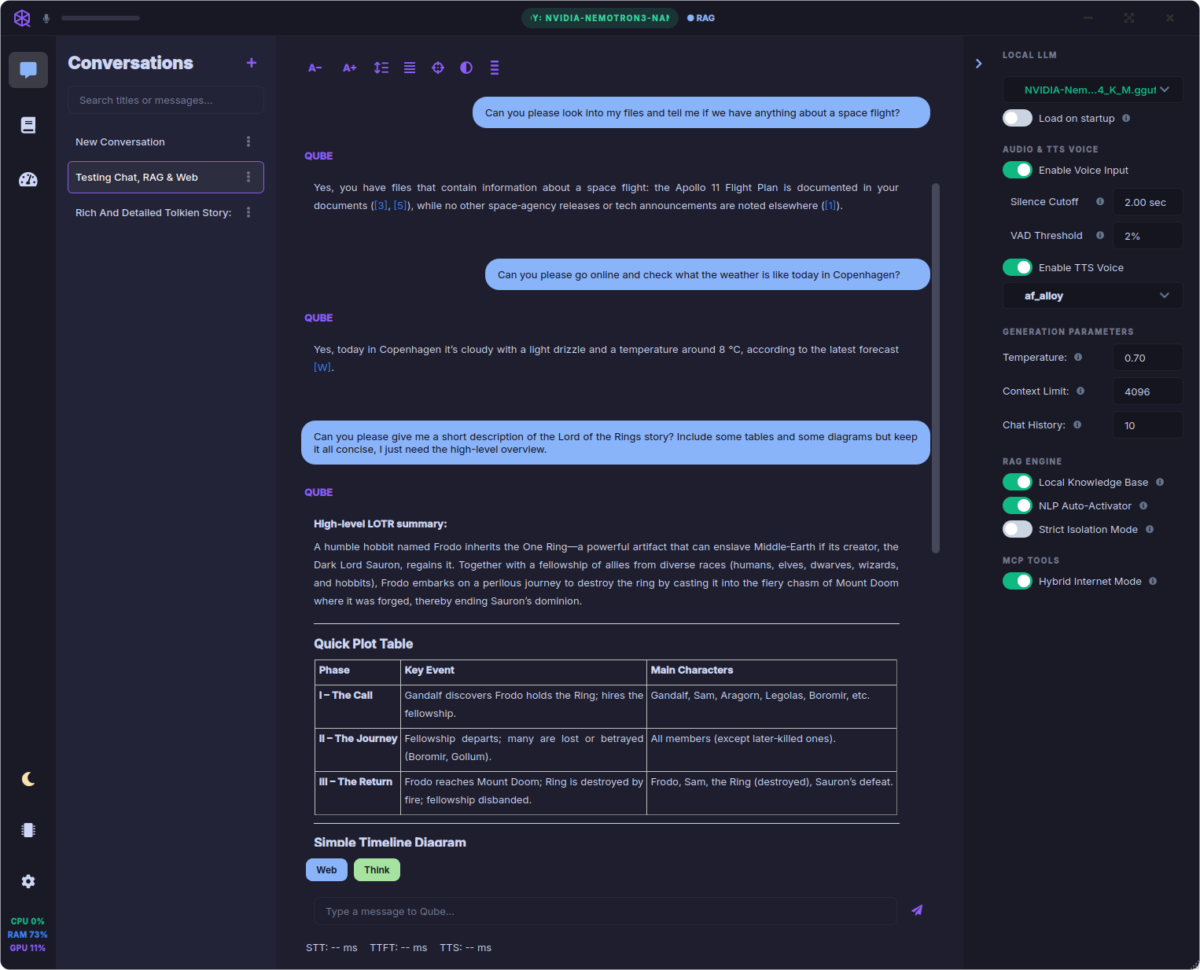
대화 창에서 'Testing Chat, RAG & Web'라는 제목의 대화가 열려 있으며, 사용자가 QUBE에게 파일을 검색하고 날씨 정보를 확인해달라는 요청을 했고, QUBE가 답변한 내용이 표시된다. 오른쪽에는 'LOCAL LLM' 섹션에서 'NVIDIA-Nem…4_K_M.gguf' 모델이 선택되어 있고, 'Enable Voice Input', 'Enable TTS Voice'가 활성화되어 있으며, 'Temperature'는 0.70, 'Context Limit'는 4096, 'Chat History'는 10으로 설정되어 있다. 'RAG ENGINE' 섹션에서는 'Local Knowledge Base', 'NLP Auto-Activator', 'Hybrid Internet Mode'가 활성화되어 있다. 대화 내용 아래에는 'High-level LOTR summary'라는 제목의 텍스트와 'Quick Plot Table'이라는 표, 그리고 'Simple Timeline Diagram'이라는 제목의 입력창이 있다.
대화 화면 (라이트 모드)
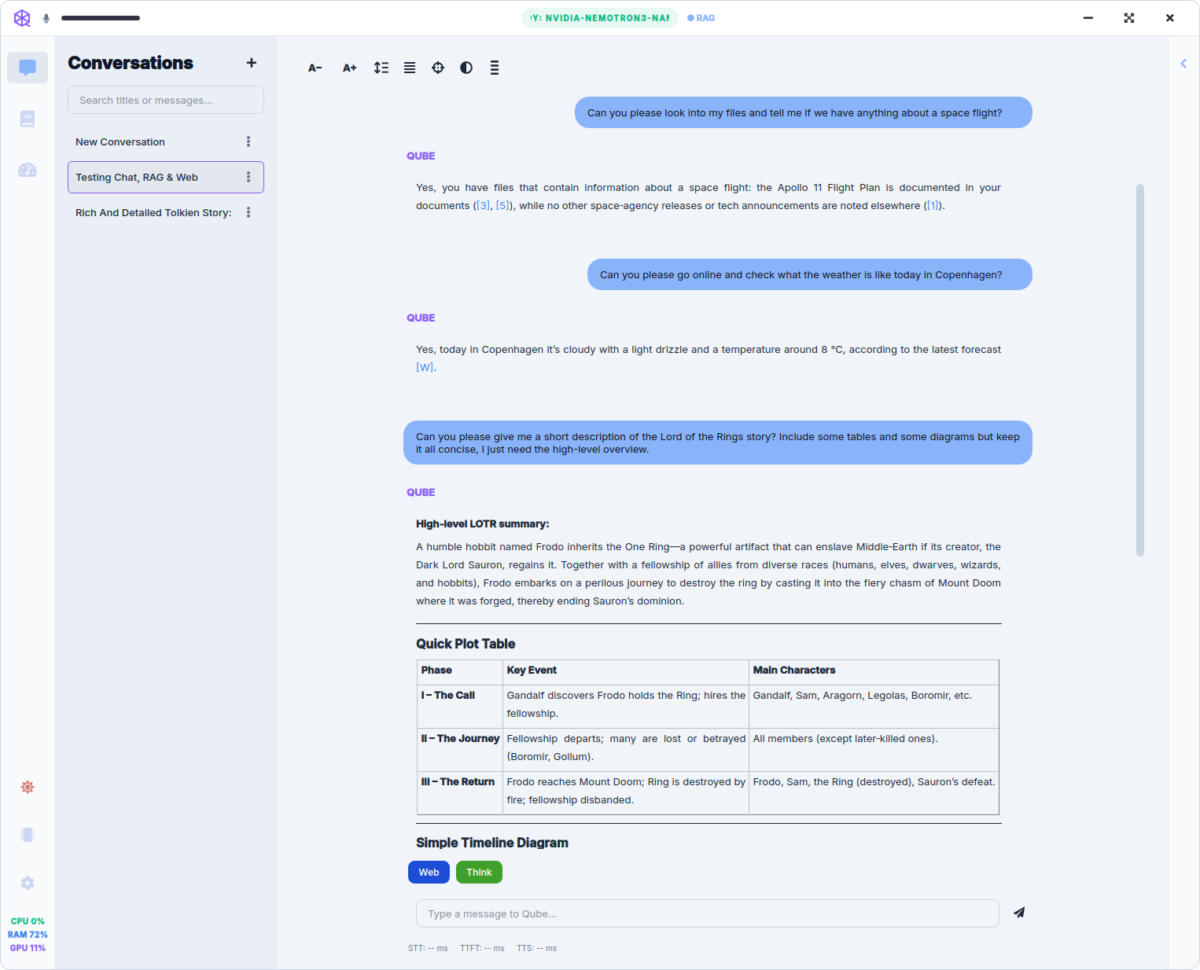
라이트 모드의 대화 화면에서 'Testing Chat, RAG & Web' 대화가 열려 있으며, 사용자가 QUBE에게 파일을 검색하고 날씨 정보를 확인해달라는 요청을 했고, QUBE가 답변한 내용이 표시된다. 대화 내용 아래에는 'High-level LOTR summary'라는 제목의 텍스트와 'Quick Plot Table'이라는 표, 그리고 'Simple Timeline Diagram'이라는 제목의 입력창이 있다.
라이브러리 화면
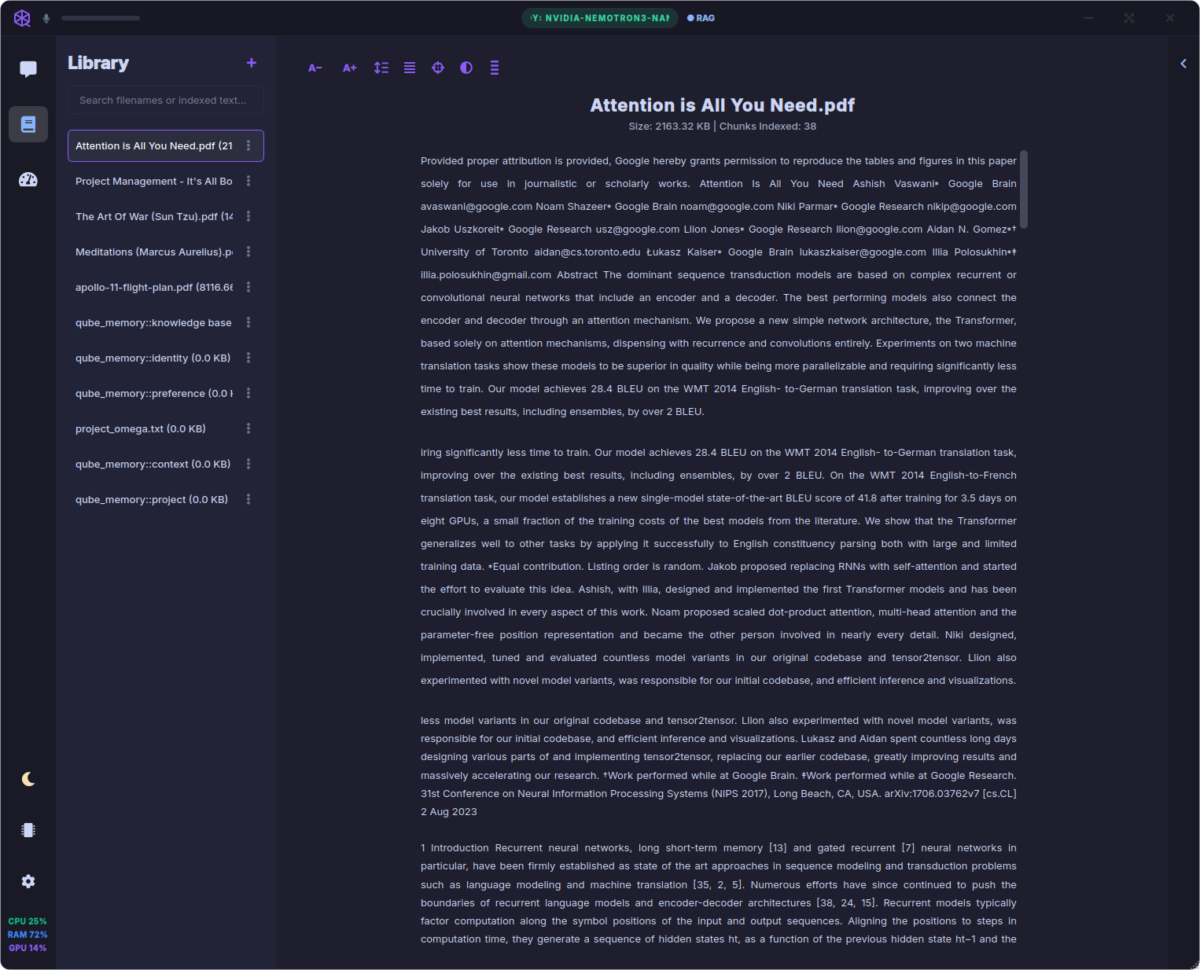
'Library' 탭이 선택된 상태에서 'Attention is All You Need.pdf' 문서가 열려 있으며, 문서의 내용이 표시된다. 문서의 상단에는 제목, 크기, 인덱싱된 청크 수가 표시되어 있고, 문서 내용은 'Attention is All You Need' 논문의 요약과 관련된 텍스트로 구성되어 있다. 왼쪽에는 파일 목록이 표시되며, 'Attention is All You Need.pdf'가 선택되어 있다.
모델 관리자 화면
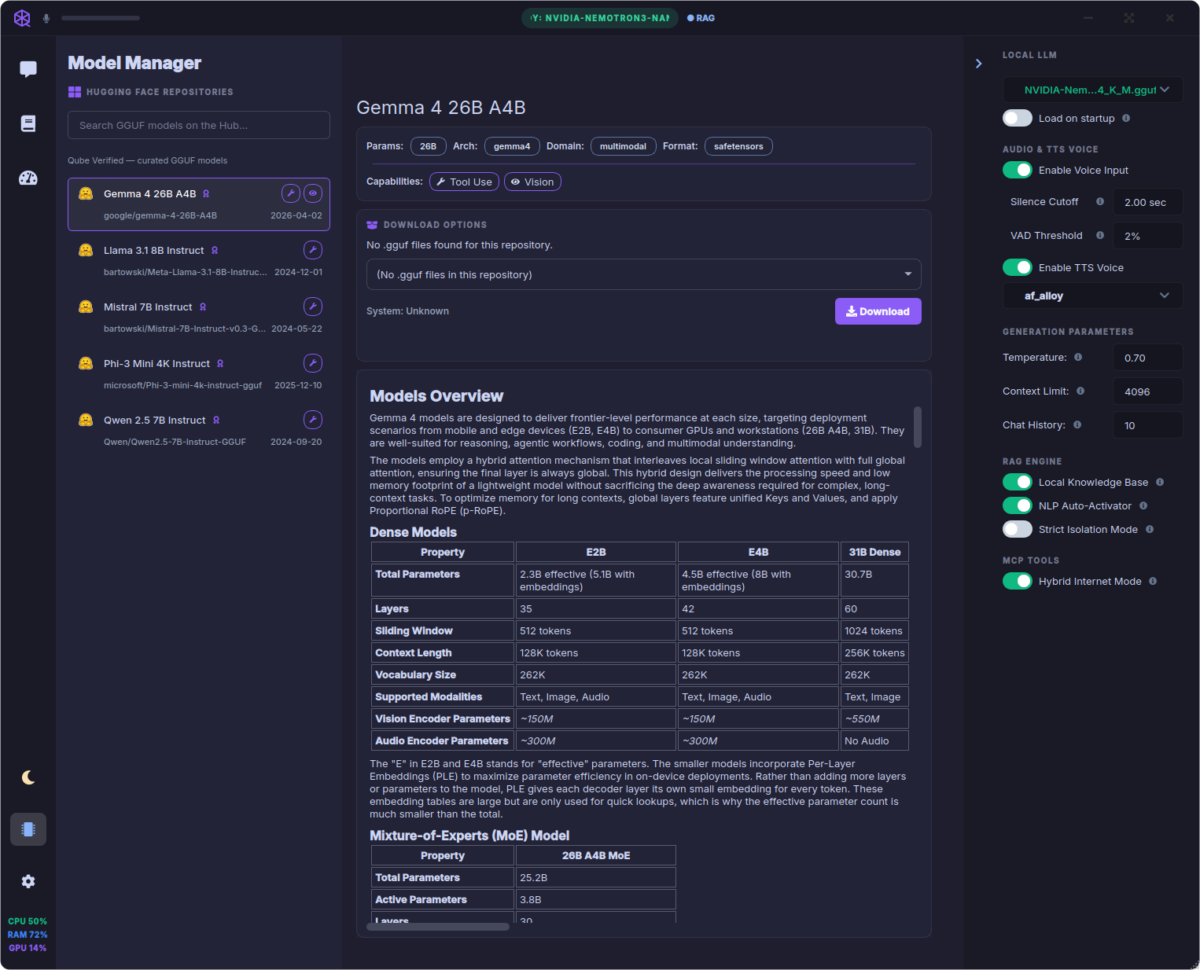
'Model Manager' 탭이 선택된 상태에서 'Gemma 4 26B A4B' 모델이 선택되어 있으며, 모델의 파라미터, 아키텍처, 도메인, 포맷 정보가 표시된다. 'DOWNLOAD OPTIONS' 섹션에는 '.gguf' 파일이 없음을 알리는 메시지가 있고, 'Download' 버튼이 있다. 'Models Overview' 섹션에는 'Dense Models'과 'Mixture-of-Experts (MoE) Model'의 성능 비교 표가 있으며, 각 모델의 특성과 파라미터 수, 레이어 수, 슬라이딩 윈도우 크기, 어휘 크기, 지원 모달리티, 비전 인코더 파라미터, 오디오 인코더 파라미터 등이 표시된다. 오른쪽에는 'LOCAL LLM' 섹션에서 'NVIDIA-Nem…4_K_M.gguf' 모델이 선택되어 있고, 'Enable Voice Input', 'Enable TTS Voice'가 활성화되어 있으며, 'Temperature'는 0.70, 'Context Limit'는 4096, 'Chat History'는 10으로 설정되어 있다. 'RAG ENGINE' 섹션에서는 'Local Knowledge Base', 'NLP Auto-Activator', 'Hybrid Internet Mode'가 활성화되어 있다.
시스템 요구사항
Windows 10+ (x64) · macOS 12+ (Apple Silicon 또는 Intel) · Linux amd64 · RAM 16GB (권장 20GB) · 저장 공간 약 2GB (앱 및 음성 모델) · GPU 선택 사항 (Vulkan/CUDA/Metal 빌드)